和地勘单位交流时,最常被问到的一个问题是:直接采购一个大模型,能不能马上用起来?这个问题背后有个普遍的预期:模型是主角,买来就能干活。但观察行业里真正跑通的项目,结论恰恰相反——模型能力正在快速同质化,拉开差距的是数据和知识。这一篇讲清楚,为什么数据是AI应用的地基。
三代数据集,决定AI能干什么
AI对数据的要求,经历了三个阶段。基础大模型时代,数据解决"知道什么",通用知识为主;行业模型时代,解决"懂什么",靠领域知识喂出专业能力;而今天智能体时代,解决的是"会做什么"——数据重心从知识本身,转向了任务目标、决策路径、工具调用和执行反馈的完整记录。2026年信通院的行业指南对此有个精准的判断:数据集的评价标准,正在从"知识供给量"转向"任务闭环还原度"。翻译成地质语言:光有规范和报告喂不出会干活的AI,得让它见过"专家是怎么干活的"——怎么判层、怎么连层、怎么处理相邻孔对不上的情况。这些过程性数据,正是绝大多数单位库里没有的。
行业证据:跑通的项目都赢在数据上
回头看行业里跑通的应用,无一例外赢在数据底座。中国地质调查局的智能找矿系统,核心是多源地学数据与专业知识的融合;四川省地质调查研究院能初步划分161个成矿远景区、圈定36处找矿预测区,靠的也是"多源数据+专业知识+算法模型"这条链路。反过来,也有一些看上去很智能的系统,因为缺了数据底座,只能停留在知识问答的演示层面——问什么都答,但答完给不出依据,更参与不了实际业务。同样的模型,喂不同的数据,出来的就是不同的东西。这不是模型好坏的问题,是地基深浅的问题。
数据集在AI应用里扮演什么角色
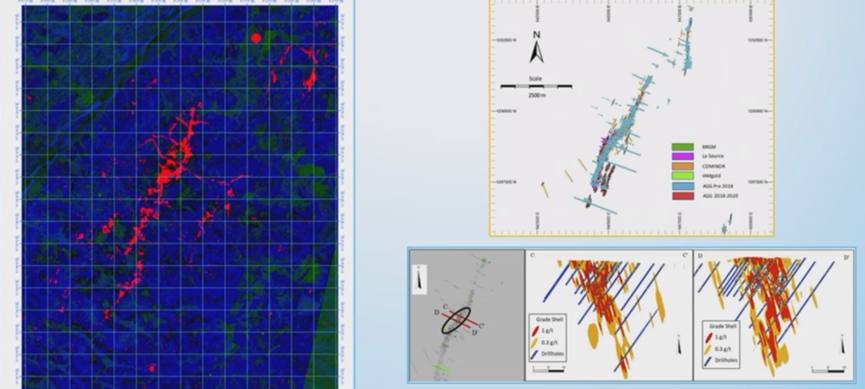
落到具体应用,数据集的价值体现在三个层面。知识问答:基于高质量行业数据集构建知识库,模型回答专业问题时的每一条结论都能回溯到标准、论文或报告原文,而不是泛泛而谈——这对地质这种"差之毫厘、谬以千里"的行业尤其重要。专业分析:找矿预测、地热评价这类任务,吃的是多源数据的融合质量——钻孔、物探、化探、遥感的数据口径统一、关联清晰,算法才可能得出可靠结论。成果生产:报告辅助编制、图表处理、质量检查,样样都以结构化、可追溯的数据为前提,没有干净的数据底座,生成出来的是"看起来像报告的文字",而不是能交付的成果。可以说,AI在地质行业能走多远,取决于数据集建到什么程度。
地基讲清楚了,具体怎么打?下一篇拆解高质量数据集的生产流水线。